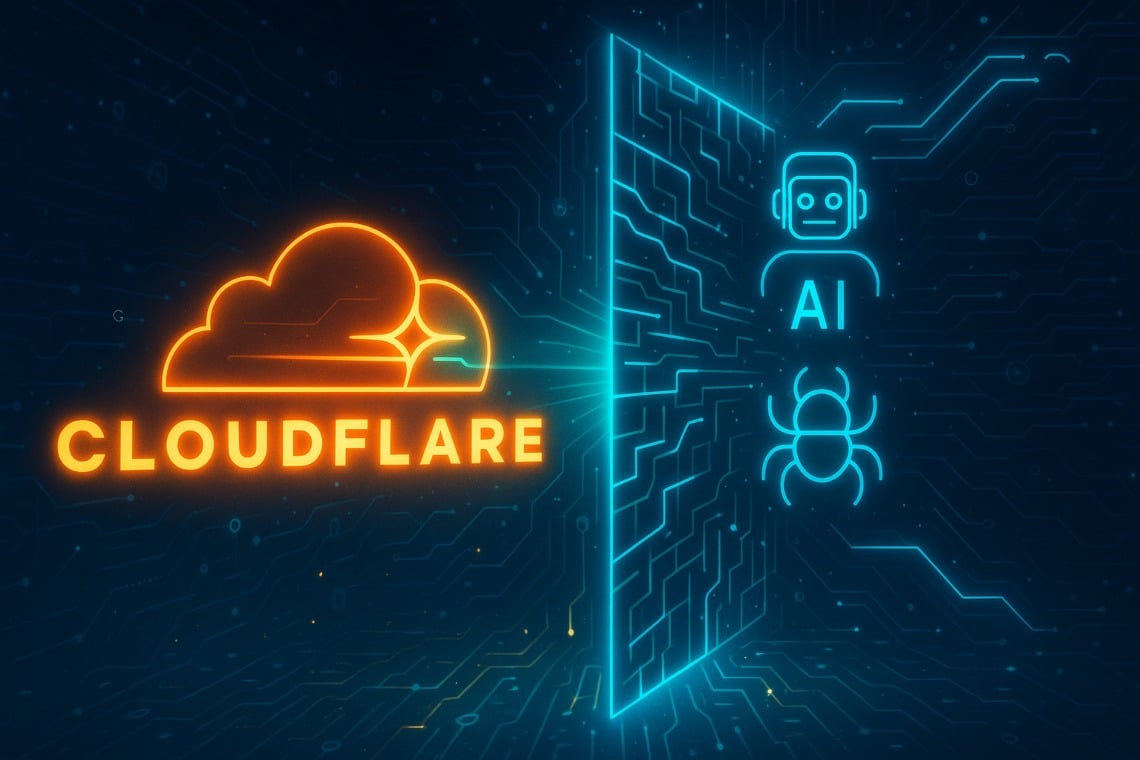
Desde Cloudflare llega un cambio trascendental: el gigante de la infraestructura de Internet bloquea los principales crawler AI para defender los contenidos en línea. Esta decisión redefine el equilibrio entre creadores, empresas tecnológicas y consumidores, prometiendo revolucionar la gestión y protección de los datos en la web.
Índice
Lucha contra los rastreadores de IA: la decisión de Cloudflare
Cloudflare ha iniciado, desde el primero de julio, una ofensiva contra las principales empresas de inteligencia artificial que recopilan datos de los sitios web sin autorización. Como declaró la misma empresa, los AI crawlers serán bloqueados por defecto en todos los nuevos sitios que adopten Cloudflare, a menos que los propietarios otorguen una autorización explícita. En el pasado, en cambio, eran los gestores de los sitios quienes debían excluir activamente a los bots AI de la recopilación de sus datos.
Esta inversión de lógica protege más del 20% del web, la cuota cubierta por los clientes de Cloudflare, y responde a los crecientes informes de ralentizaciones y problemas causados por flujos extraordinarios de solicitudes automatizadas provenientes de los bots de grandes nombres de la IA como GPTBot de OpenAI y ClaudeBot de Anthropic.
Impacto de los crawler AI: los números del fenómeno
El volumen de tráfico generado por los AI crawling bots ha alcanzado niveles impresionantes. Por ejemplo, GoogleBot ha detectado que Vercel, servicio de cloud-hosting, recibe más de 4,5 mil millones de solicitudes al mes de estos software. A diferencia de los crawlers de motores de búsqueda normales, los bots AI tratan a los servidores de manera agresiva, visitando las mismas páginas varias veces en pocas horas o bombardeando los sitios con cientos de solicitudes por segundo.
¿El resultado? Sitios más lentos, dificultad de acceso para usuarios reales y una sensación generalizada de ser objeto de una verdadera «extracción» de contenidos sin reglas ni compensaciones. Numerosos editores y empresas, desde The Associated Press hasta Condé Nast y Ziff Davis, han denunciado la práctica de la recopilación masiva y no autorizada por parte de las big tech del AI.
Nuevas reglas y tecnologías para defender los contenidos
La movida de Cloudflare no se limita a una prohibición superficial. La empresa ha anunciado el uso de machine learning y análisis comportamental para detectar también los llamados “shadow scrapers”, bots disfrazados que intentan eludir los bloqueos convencionales. De esta manera, no solo los crawlers declarados sino también los intentos más sofisticados de scraping serán interceptados.
Además, los proveedores de AI deberán ahora pedir permiso antes de poder acceder a los datos, indicando claramente los objetivos de uso, ya sea para el entrenamiento de los algoritmos o para simples funciones de búsqueda. Cloudflare devuelve así a los editores la posibilidad de decidir quién puede interactuar con su información.
Las protestas de los principales grupos editoriales han favorecido el nacimiento de esta nueva política. Los actuales sistemas de exclusión, como el tradicional robots.txt, a menudo son ignorados por los bots de IA, que tienden a “minar” la web sin seguir las normas de respeto por la propiedad intelectual digital.
Pay Per Crawl: hacia un nuevo modelo económico para los contenidos
La revolución firmada Cloudflare introduce también otra novedad: el programa Pay Per Crawl. Este sistema, hoy en fase beta privada, permitirá a los editores establecer precios de acceso para quienes deseen utilizar sus contenidos con fines de entrenamiento de IA. El acceso será autorizado solo mediante pago, o negado en caso contrario.
Desde el punto de vista técnico, Cloudflare utilizará el código HTTP 402 «Payment Required», devuelto a los rastreadores no habilitados. Una solución potencialmente eficaz, ya lista para la implementación gracias a su compatibilidad con los sistemas web existentes.
Las reacciones del mundo AI y los nudos normativos
La decisión de Cloudflare influye directamente en las empresas de IA, hasta ahora reacias a pagar licencias o compensaciones. Nicholas Thompson, CEO de The Atlantic, ha subrayado cómo hasta hoy las compañías podían actuar impunemente, mientras que ahora tendrán que negociar y reconocer la propiedad de los contenidos. Por otro lado, algunos líderes del mundo tecnológico, como Nick Clegg de Meta, advierten que la introducción de restricciones estrictas podría poner en riesgo el crecimiento y la innovación en el sector de IA.
El debate se extiende también al plano normativo. Un informe de la Copyright Office ha reconocido que ciertos usos de las tecnologías generativas pueden ser “transformativos”. Sin embargo, la recopilación masiva sin consentimiento no puede ser considerada fair use. Una posición que ha tenido graves repercusiones institucionales, incluida la sustitución inmediata de la responsable de la Oficina de Propiedad Intelectual por parte de la administración Trump.
El futuro de la protección de los contenidos online
La iniciativa de Cloudflare rediseña los equilibrios entre quienes crean y quienes explotan los contenidos en línea. La posibilidad de bloquear y monetizar el acceso a los datos ofrece a los editores un poder real sobre dónde y cómo se utilizan sus obras. Como consecuencia, muchas empresas de IA tendrán que reorganizar estrategias y procesos de adquisición de datos, impulsando hacia una mayor transparencia y colaboración con el mundo editorial.
Mientras el ecosistema digital se adapta a este cambio de paradigma, es probable que otros grandes actores del sector infraestructural sigan el ejemplo de Cloudflare. De esta manera se puede desencadenar una nueva era en la defensa de los derechos digitales, donde quien produce valor es incentivado y protegido. Quedan abiertas las preguntas sobre los tiempos y las modalidades de la adopción del modelo Pay Per Crawl y sobre los efectos que tendrá en el desarrollo de las inteligencias artificiales.
En un contexto en continua transformación, monitorear la evolución de las estrategias anti-crawler AI y participar activamente en el debate se vuelve fundamental para todas las realidades involucradas. La guerra a los bots no autorizados podría ser solo el inicio de una nueva temporada para la valorización del web como bien colectivo y sostenible.